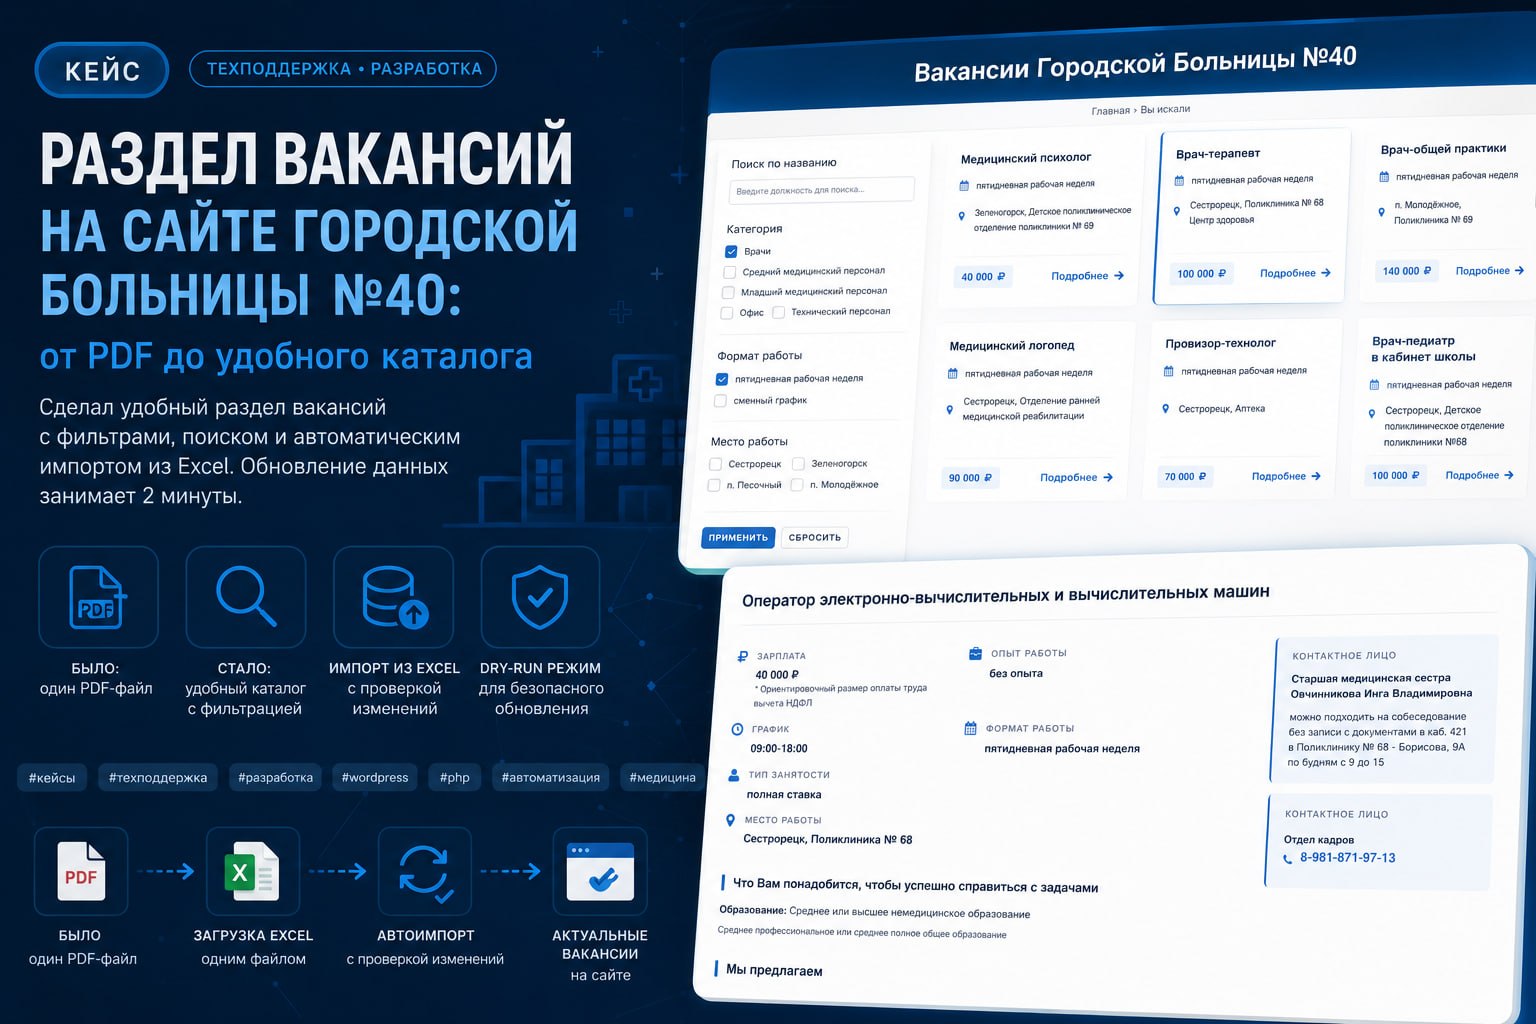
В рамках техподдержки сайта Городской больницы №40, который обслуживаю уже более 4 лет, сделал удобный раздел вакансий.
Раньше вакансии выкладывали одним PDF-файлом, а вакансий у больницы много — сейчас в базе более 200 позиций. Теперь всё структурировано, фильтруется и обновляется в пару кликов. Казалось бы, обычный каталог вакансий, но пришлось повозиться с импортом.
Было
- На сайте висел один PDF-файл со списком вакансий.
- Отдел кадров обновлял его раз в неделю, но актуальность терялась быстро — вакансии обновляются чуть ли не каждый день.
- Соискатели не могли найти нужную специальность — приходилось листать 20 страниц. Многие просто звонили на общий номер и загружали сотрудников вопросами.
Файл был неструктурированным: без фильтров, без контактов конкретных отделов. Итог — потерянные кандидаты и лишняя нагрузка на персонал.
Задача была не усложнять работу и так загруженному HR-менеджеру, сохранив загрузку одним файлом, как было раньше. Помог структурировать таблицу, не перегружая её, — каждый шаг согласовывал с отделом кадров.
Стало
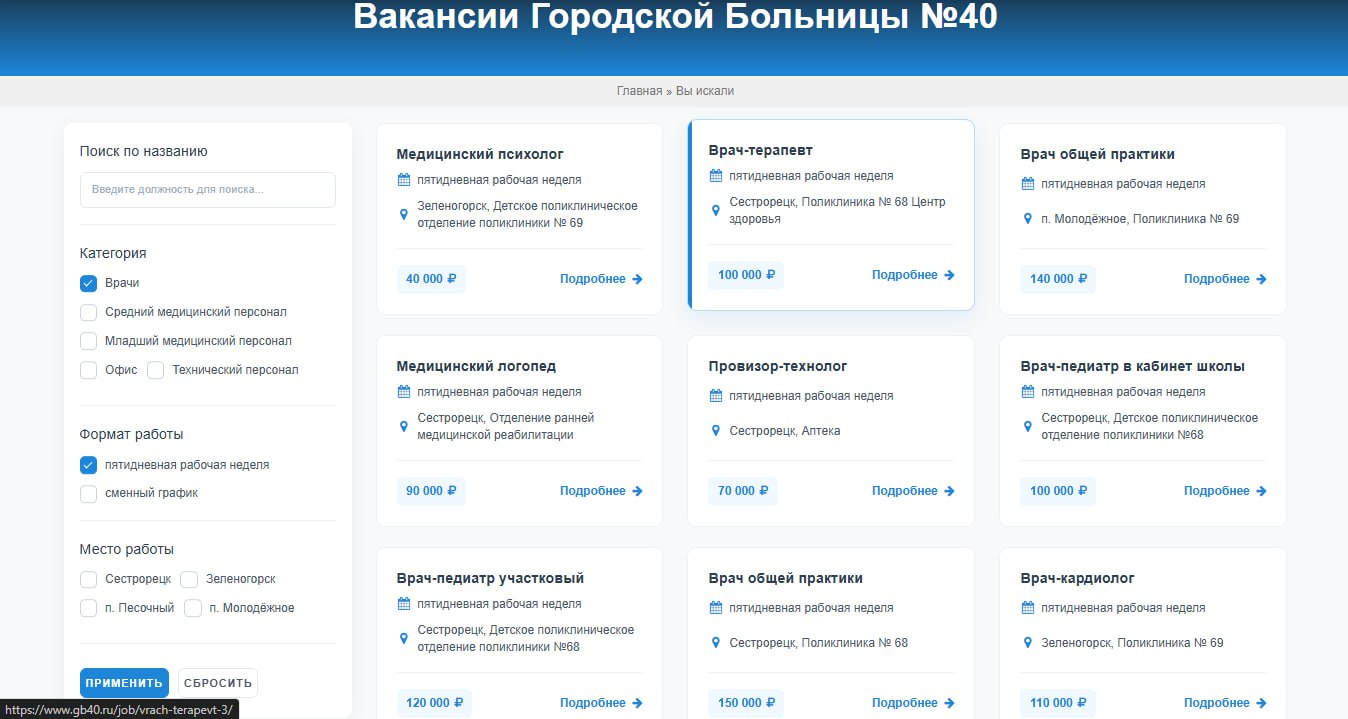
Полноценный раздел «Вакансии» (https://www.gb40.ru/job/):
- каталог карточек с фильтрацией по категориям, формату работы и локации;
- поиск по названию должности;
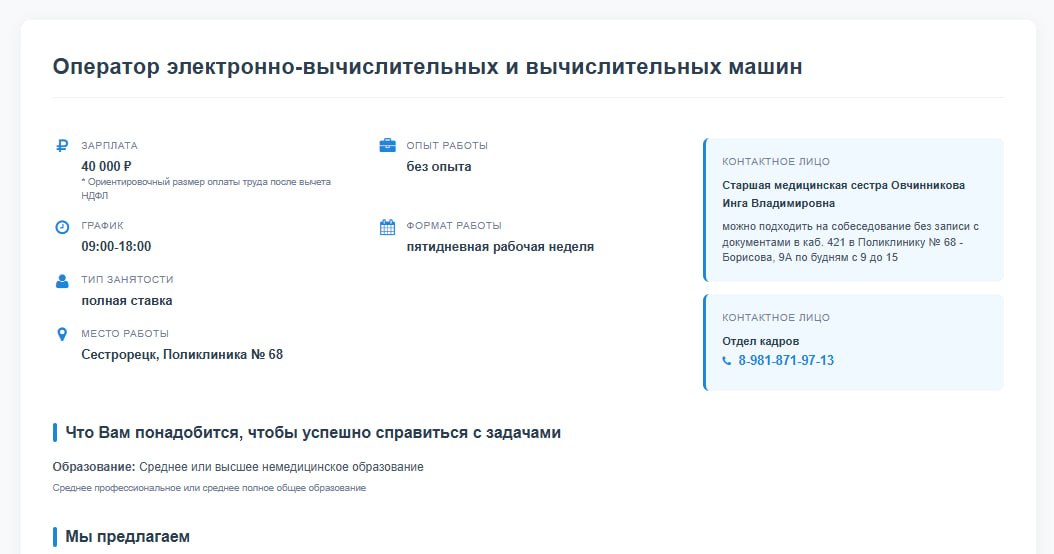
- контактные данные отдела кадров и ответственных лиц;
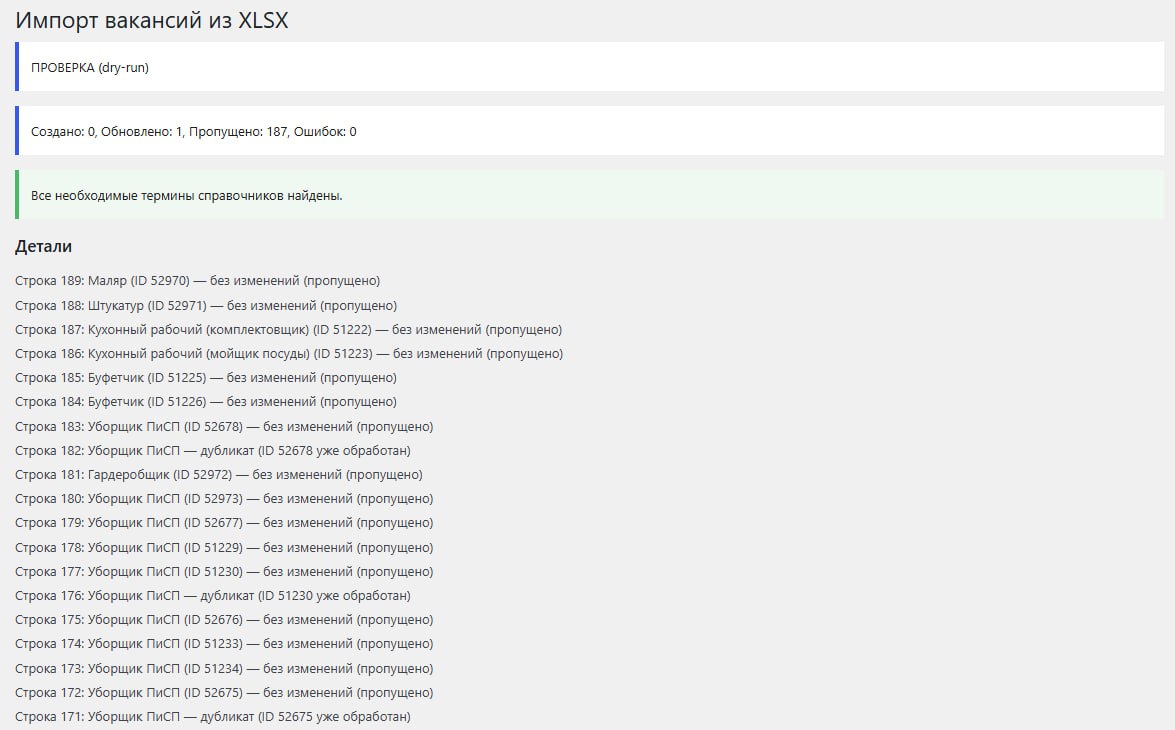
- автоматический импорт из Excel с проверкой изменений (dry-run режим для безопасности).
Теперь сайт показывает только актуальные вакансии, а обновление данных занимает 2 минуты.
Сложность кейса
У вакансий нет уникального номера (как артикул у товара). Поэтому при импорте ищу существующую вакансию по трём параметрам: название должности + отделение + локация.
Если совпадают — обновляем, если нет — создаём новую. Дублирующиеся строки из Excel отсекаются, чтобы не плодить копии. Это потребовало:
- согласования структуры таблицы с отделом кадров — чтобы им было удобно вести данные, а мне — парсить;
- алгоритма поиска дублей с учётом пробелов и регистра;
- сравнения всех полей (график, зарплата, образование, контакты) перед обновлением, чтобы не перезаписывать без необходимости;
- режима dry-run — показывает, что изменится, но не пишет в базу, чтобы HR проверил импорт до применения.
Стек
- Backend: PHP (WordPress), ACF, таксономии, кастомные типы постов.
- Импорт: библиотека SimpleXLSX, собственный класс сравнения данных.
- Frontend: HTML, CSS (Bootstrap), JavaScript (jQuery), адаптивная вёрстка.